miércoles, 17 de abril de 2013

martes, 16 de abril de 2013
Actividad 5 - Algoritmo Distribuido
Una subclase de los algoritmos paralelos, los algoritmos distribuidos son algoritmos diseñados para trabajar en entornos tipo clusters y de computación distribuida, donde se usan otras técnicas, fuera del alcance de los algoritmos paralelos clásicos.
El algoritmo de Chandy y Lamport, bajo determinadas suposiciones, permite determinar el estado global de un sistema distribuido
Las instantáneas reflejan sólo estados consistentes.
Si el estado de P, dice que P ha recibido un mensaje de Q, en la instantánea, Q envió antes un mensaje a P.
La noción de estado global se refleja por el concepto de corte.
Estado Global
Estado global: estado local de cada proceso + estado de cada canal.
Estado de cada proceso: sólo las variables que nos interesen.
Estado de cada canal: mensajes enviados y todavía no entregados.
- Usos del estado global:
- Detección de terminación.
- Depuración distribuida.
Algoritmo de Chandy-Lamport
El algoritmo de Chandy y Lamport, bajo determinadas suposiciones, permite determinar el estado global de un sistema distribuido
Conceptos previos
Una instantánea distribuida refleja el estado que pudo haberse alcanzado en el sistema.Las instantáneas reflejan sólo estados consistentes.
Si el estado de P, dice que P ha recibido un mensaje de Q, en la instantánea, Q envió antes un mensaje a P.
La noción de estado global se refleja por el concepto de corte.
- Cualquier proceso inicia el algoritmo.
- Sea P el proceso iniciador.
- P guarda su estado local, luego envía un mensaje de marca a todos los demás procesos.
- Cuando un proceso recibe el mensaje de marca:
- Si no ha guardado su estado local: guarda su estado local y envía marca a todos los demás procesos. A partir de este momento almacenará lo que llegue por los canales entrantes.
- Si ha guardado su estado local, guarda los mensajes recibidos por el canal (desde que el proceso guardó su estado local, hasta que recibió marca por este canal).
- Un proceso termina, cuando ha recibido marca por todos los canales.
- Cuando termina, envía su estado y el de sus canales al iniciador.
jueves, 28 de febrero de 2013
Actividad 3 - Algoritmo Paralelo. Aplicación en 3 Lenguajes de Programación
Para nuestra 3ª actividad, implementaremos el algoritmo paralelo descrito en la Actividad 2, en 3 lenguajes de programación diferentes.
Cabe mencionar que la paralelización como tal sera implementada por medio de hilos, los cuales se ejecutan simultaneamente efectuando las operaciones de "acomodar" los números de nuestro arreglo.
Cabe mencionar que la paralelización como tal sera implementada por medio de hilos, los cuales se ejecutan simultaneamente efectuando las operaciones de "acomodar" los números de nuestro arreglo.
Diagrama de Flujo
Ejemplo en Java
Para el ejemplo en java, utilizamos una sola clase, la cual implementa los metodos de la clase Runnable y nos permite instanciarla como un hilo independiente, cada vez que se ejecuta el metodo run()
Para el acomodo de los objetos utilizamos el metodo de ordenamiento QuickSort
Ejemplo en Ruby
Implementacion de hilos en Ruby
Metodo de ordenamiento QuickSort en Ruby
Ejemplo en Python
Implementacion de hilos en Python
Metodo de ordenamiento QuickSort en Python
jueves, 21 de febrero de 2013
Actividad 2 - Algoritmo Paralelo (QuickSort)
Una de las más importantes utilidades de los multi-computadores es su uso en la computación algorítmica para obtener velocidad y eficacia. Se propone el diseño e implementación de un algoritmo paralelo que implemente las metodologías de Divide y Vencerás aplicado al QuickSort.


Divide y Vencerás
La estrategia Divide y Vencerás consiste en descomponer un problema en subproblemas más simples del mismo tipo, resolverlos de forma independiente y una vez obtenidas las soluciones parciales combinarlas para obtener la solución del problema original.

QuickSort
El ordenamiento rápido (quicksort en inglés) es un algoritmo creado por el científico británico en computación C. A. R. Hoare basado en la técnica de divide y vencerás, que permite, en promedio, ordenar n elementos en un tiempo proporcional a n log n.(fuente)
El algoritmo trabaja de la siguiente forma:
- Elegir un elemento de la lista de elementos a ordenar, al que llamaremos pivote.
- Re-situar los demás elementos de la lista a cada lado del pivote, de manera que a un lado queden todos los menores que él, y al otro los mayores. Los elementos iguales al pivote pueden ser colocados tanto a su derecha como a su izquierda, dependiendo de la implementación deseada. En este momento, el pivote ocupa exactamente el lugar que le corresponderá en la lista ordenada.
- La lista queda separada en dos sublistas, una formada por los elementos a la izquierda del pivote, y otra por los elementos a su derecha.
- Repetir este proceso de forma recursiva para cada sublista mientras éstas contengan más de un elemento. Una vez terminado este proceso todos los elementos estarán ordenados.
Como se puede suponer, la eficiencia del algoritmo depende de la posición en la que termine el pivote elegido.
- En el mejor caso, el pivote termina en el centro de la lista, dividiéndola en dos sublistas de igual tamaño. En este caso, el orden de complejidad del algoritmo es O(n·log n).
- En el peor caso, el pivote termina en un extremo de la lista. El orden de complejidad del algoritmo es entonces de O(n²). El peor caso dependerá de la implementación del algoritmo, aunque habitual mente ocurre en listas que se encuentran ordenadas, o casi ordenadas. Pero principal mente depende del pivote, si por ejemplo el algoritmo implementado toma como pivote siempre el primer elemento del array, y el array que le pasamos está ordenado, siempre va a generar a su izquierda un array vacío, lo que es ineficiente.
- En el caso promedio, el orden es O(n·log n).
No es extraño, pues, que la mayoría de optimizaciones que se aplican al algoritmo se centren en la elección del pivote.La implementación del método Divide y Vencerás sobre el algoritmo de QuickSort, quedaría representada por la siguiente imagen:
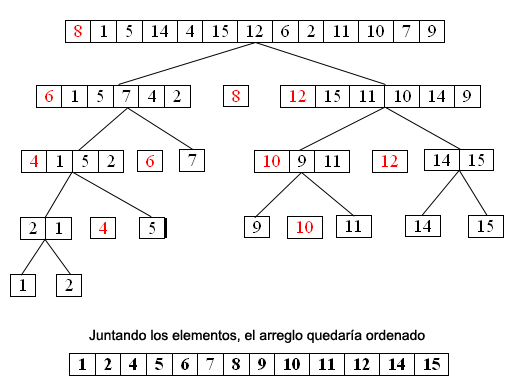
Donde:
- Tendremos un arreglo de números inicial.
- Seleccionaremos el primer número de la lista el cual sera nuestro pivote.
- Un nuevo proceso acomodara los números menores al pivote en un nuevo arreglo y los mayores al pivote en otro arreglo.
- Crearemos nuevos procesos para los siguientes arreglos, siguiendo esta metodología hasta llegar a las "hojas" de nuestro árbol.
- Al terminar, los procesos devolverán su correspondiente resultado ya ordenado al proceso principal el cual únicamente los acomodara y dará un resultado.
En la práctica, este algoritmo se maneja de forma iterativa, nosotros buscamos mejorar el tiempo de respuesta en este de por si rápido algoritmo de ordenamiento por medio de la paralelización.
Suscribirse a:
Entradas (Atom)